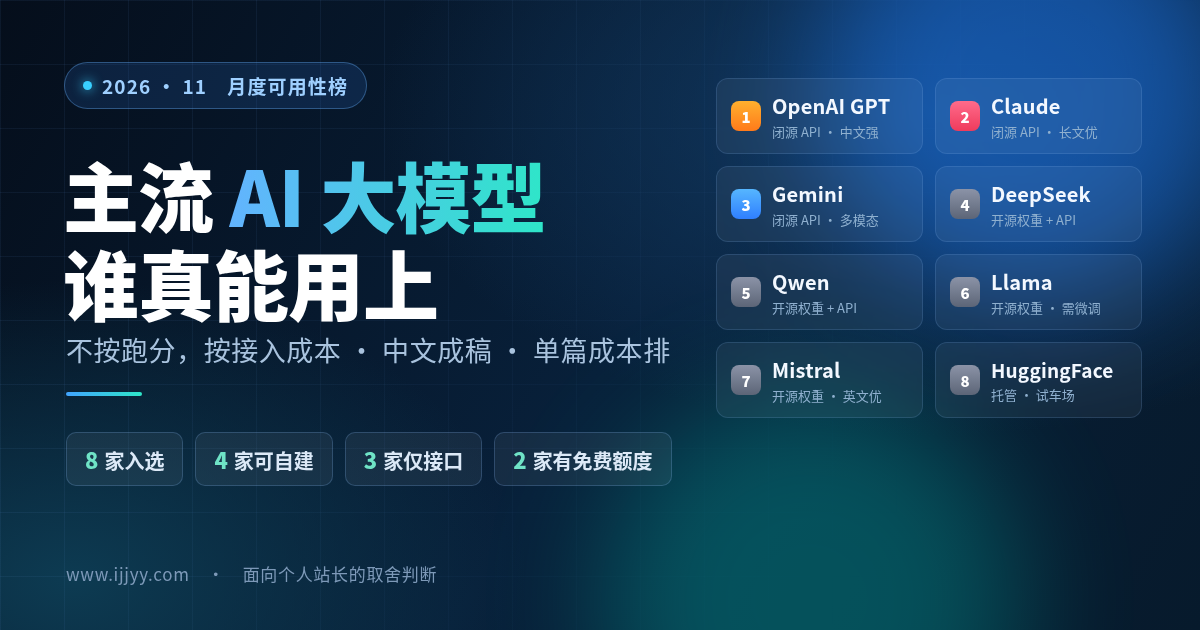
2026 年 11 月 · 大模型可用性榜
不看跑分,看你能不能真的用上
这次不按参数和跑分排,按一个自己维护网站的人能不能接上、接上之后中文够不够用、一个月要花多少钱来排。
8 家入选
4 家可自建
3 家仅有闭源 API
2 家有免费/试用额度
一、为什么按“能不能真用上”排
个人站长挑模型,跑分榜其实没什么参考价值。真正决定能不能用起来的只有三件事:接不接得进现在的流程、中文长文写出来像不像人话、一个月的账单会不会失控。
所以这张榜不按参数排。我把接入成本、中文成稿率、单篇成本三项放一起打分,最后选进来 8 家:4 家权重能下载、可以自己部署,3 家只能调接口,剩下 Hugging Face 算试车场——它不产模型,但能让你在掏钱之前把候选试个遍。
数字都是 2026 年 11 月 10 日的快照。价格、免费额度、许可条款都会变,真要落笔之前回官网再核一遍,别把这张表当长期合同。
8 家构成4 家可自建、3 家仅接口、1 家托管试车场
快照口径2026-11-10 读数,用前回官网复核
二、这几家现在各自站在哪
格局比想象中清楚。开源这一侧是 DeepSeek、Qwen、Llama、Mistral:权重能拿,代价是显存和部署得自己扛;闭源一侧是 OpenAI、Claude、Gemini,接上就能写,账单跟着用量走。
中文是分水岭。OpenAI、Claude、Gemini、DeepSeek、Qwen 五家写中文长文已经能直接发,术语和语感基本不用返工;Llama 和 Mistral 得靠中文微调或者提示词硬拽,直接批量产稿会露出翻译腔。
成本也是三档:免费和试用额度只够验证,跑不起日更;按量计费在长文、长上下文场景会成倍涨;自建是一次性买显存,之后基本只剩电费。
开源 4 家DeepSeek / Qwen / Llama / Mistral,权重可下载
闭源 3 家OpenAI / Claude / Gemini,接上即用、按量计费
三、逐家拆解:能不能真接进你的站
| 排名 |
模型/生态 |
厂商 |
获取方式 |
中文表现 |
适合谁 |
| 1 |
OpenAI GPT 系列 |
OpenAI |
闭源 API(有免费试用额度) |
强 |
要稳定产出、不想折腾部署 |
| 2 |
Anthropic Claude 系列 |
Anthropic |
闭源 API |
较强(长文尤佳) |
长文改写、审稿、结构化拆解 |
| 3 |
Google Gemini 系列 |
Google |
闭源 API(含免费额度) |
较强 |
多模态、图片与文档混合处理 |
| 4 |
DeepSeek 系列 |
DeepSeek |
开源权重 + 便宜 API |
强 |
要自建又要中文质量 |
| 5 |
阿里 Qwen 系列 |
阿里巴巴 |
开源权重 + API |
强(中文语料厚) |
中文内容、Agent 工具链 |
| 6 |
Meta Llama 系列 |
Meta |
开源权重 |
中(需中文微调或加提示) |
想完全本地跑、数据不出门 |
| 7 |
Mistral 系列 |
Mistral AI |
开源权重 + API |
中(英文优于中文) |
英文站、多语言站点 |
| 8 |
Hugging Face 生态 |
社区/多厂商 |
模型托管与推理服务 |
看具体模型 |
想先试再定、爱换模型 |
「获取方式」分闭源 API 与开源权重两类;「中文表现」是按长文改写、术语准确性、口语自然度三项主观打分后的粗档,不引用第三方基准数字。
下面逐家给判断。每张卡片的四个格子固定是“是什么、能做什么、坑在哪、适合谁”,顺序一致,方便横向比。先读“坑在哪”,再看功能清单,能省不少试错。
四格判断法是什么 / 能做什么 / 坑在哪 / 适合谁
TOP1
O
OpenAI GPT 系列
最省心的通用选择:接上就能用,出问题也最好搜到答案。
OpenAI闭源 API
获取方式闭源 API(有试用额度)
中文表现强
内容生产主力
它是什么
闭源商用模型,按 token 计费,官方提供 SDK 与兼容 OpenAI 格式的接口,几乎所有第三方工具都优先适配它。
站长的自动化流水线里当「写作与判断」的那一环:选题扩写、长文改写、结构化抽取,再交给 n8n 落库成草稿。
成本和用量强耦合,长上下文与批量跑会迅速吃额度;接口格式虽被广泛兼容,但版本切换时输出风格会漂。
接上最快:一个 API Key 加一个兼容层即可,不需要显卡。
TOP2
Anthropic Claude 系列
长文改写和审稿最稳的一档,缺点是贵且不太好白嫖。
Anthropic闭源 API
它是什么
闭源模型,以长上下文和指令跟随见长,输出更「像人写的」,也更愿意按你给的格式办事。
拿它做编辑角色:把草稿喂进去,让它按「删掉形容词、补一句判断、保留数字」这类规则改,比让它从零写更值。
按量付费单价偏高,批量改写要先算成本;国内访问需要处理网络与合规问题,别把关键链路只挂在一家。
中等:接口简单,但要配好重试与超时,长文请求容易超时。
TOP3
Google Gemini 系列
多模态最好用的一档:图片、PDF、表格能一起喂进去。
Google闭源 API
获取方式闭源 API(有免费额度)
中文表现较强
多模态处理
它是什么
闭源模型家族,图像理解与文档解析能力强,官方有免费额度适合先试。
站长常拿它做「截图转文字」「PDF 转结构化字段」这类脏活,把素材先过一遍再交给写稿模型。
免费额度有速率限制,跑批容易被掐;输出有时过于概括,事实细节仍要人工回查。
TOP4
DeepSeek 系列
自建性价比最高的一档:中文够用,权重开放,API 也便宜。
DeepSeek开源权重 + API
获取方式开源权重 + API
中文表现强
自建首选
它是什么
既有开源权重可本地部署,也有官方 API,中文语料充足,长上下文版本适合读整篇文章。
在家用机器或小服务器上跑蒸馏版做日常改写,重活再切官方 API,成本能压到很低。
本地跑要吃显存,量化后质量会掉;开源权重的中文长文稳定性不如闭源大版本。
中:需要一点显存和 Ollama/llama.cpp 的经验。
TOP5
阿里 Qwen 系列
中文和工具调用都顺手,生态里适配得最全的一档开源模型。
阿里巴巴开源权重 + API
获取方式开源权重 + API
中文表现强
Agent 工具链
它是什么
开源模型家族,尺寸覆盖从手机端到服务器端,中文与函数调用能力在开源里比较靠前。
给 n8n 或自建 Agent 当执行模型:调用接口、填表、抽取字段,指令跟随比同尺寸模型稳。
版本迭代快,同一名字下不同尺寸效果差异大;本地部署要按显存挑尺寸,别硬上大杯。
TOP6
Meta Llama 系列
生态最广的开源基座,中文要靠提示或微调补。
Meta开源权重
它是什么
开源基座模型,工具链和量化方案最成熟,几乎所有本地推理框架都优先支持。
追求数据不出门时用它:把站内素材喂给本地实例做摘要、打标签,不经过任何外部接口。
中文原生能力一般,长篇写作容易出现英文腔;商用条款要看具体版本,别默认都能随便用。
TOP7
Mistral 系列
英文站和多语言站点的性价比选项,中文别抱太大期待。
Mistral AI开源权重 + API
获取方式开源权重 + API
中文表现中
多语言站点
它是什么
欧洲厂商的开源模型,小尺寸版本跑得动、速度快,英文质量稳定。
做英文站或需要批量翻译时,用它先出草稿,再让中文模型润色,成本和延迟都低。
中文不是强项,直接产出中文长文会出现用词生硬;部分版本商用条款另有要求。
TOP8
Hugging Face 生态
不是一个模型,而是「先试再定」的地方,模型选择成本最低。
社区/多厂商模型托管与推理服务
获取方式托管 + 推理端点
中文表现看具体模型
试验与选型
它是什么
开源模型的托管与分发平台,能直接调推理端点,也能下载权重自己部署。
选型阶段用它横向试几个模型:同一段提示词跑五家,比较中文自然度,再决定自建谁。
模型质量参差,同名不同版本效果差别大;免费推理端点会排队,不适合放进生产链路。
四、按站型配组合
日更内容站,我建议把链路拆成两段:Gemini 把官网、定价页、更新日志读成结构化字段,Claude 或 DeepSeek 把字段写成能读的段落,最后 n8n 直接落成 WordPress 草稿。这样只有一个付费接口在跑批量,成本可控,出问题也好定位。
做评测站或导航站的,别自己写产品描述。让 Gemini 读页面、GPT 或 Claude 拼初稿,你只做两件事:核对事实、下判断。模型给的是素材,取舍还是人的活。
想完全本地、素材不出内网的,DeepSeek 加 Qwen 量化跑在 24G 显存上够用,但只适合摘要、分类、打标签这类短任务。让 7B 级别写中文长文,读者一眼能看出干瘪,别拿它当唯一写稿模型。
日更内容站抓取 → 成稿 → 落库Gemini 读页面 · Claude / DeepSeek 写段 · n8n 存草稿只有一个付费接口在跑批量
评测 / 导航站读页面 → 拼初稿 → 人复核Gemini 结构化 · GPT 或 Claude 拼稿 · 你定结论模型给素材,取舍留给人
全本地素材不出内网DeepSeek + Qwen 量化 · 24G 显存跑摘要分类写中文长文会干瘪,别当唯一写稿模型
五、结论与发布前复核
三句话收尾:跑分高不等于你接得上,别为分数买单;中文长文优先闭源头部,省下的返工时间比省下的接口费值钱;想压成本就“闭源写、开源改”,别指望一套模型通吃。
发布前必须人工核三样:接口价格与免费额度的当前条款、开源权重的商用许可、以及文中所有带“≈”的数字口径。这三样变得比模型还快。
1别为跑分买单跑分高,不等于接得进你的流程
2中文长文优先闭源头部省下的返工时间比接口费值钱
3闭源写、开源改混合链路才压得住成本
参考来源